RAG: respuestas sustentadas en tus documentos
En el segundo taller cada persona construye un bot que responde con sus propios documentos, cita de cuál sacó la respuesta y admite cuando algo no está ahí. No instala ninguna base de datos.
Abrir el notebook original T2 · .ipynbPaso 2El modelo no conoce tus documentos
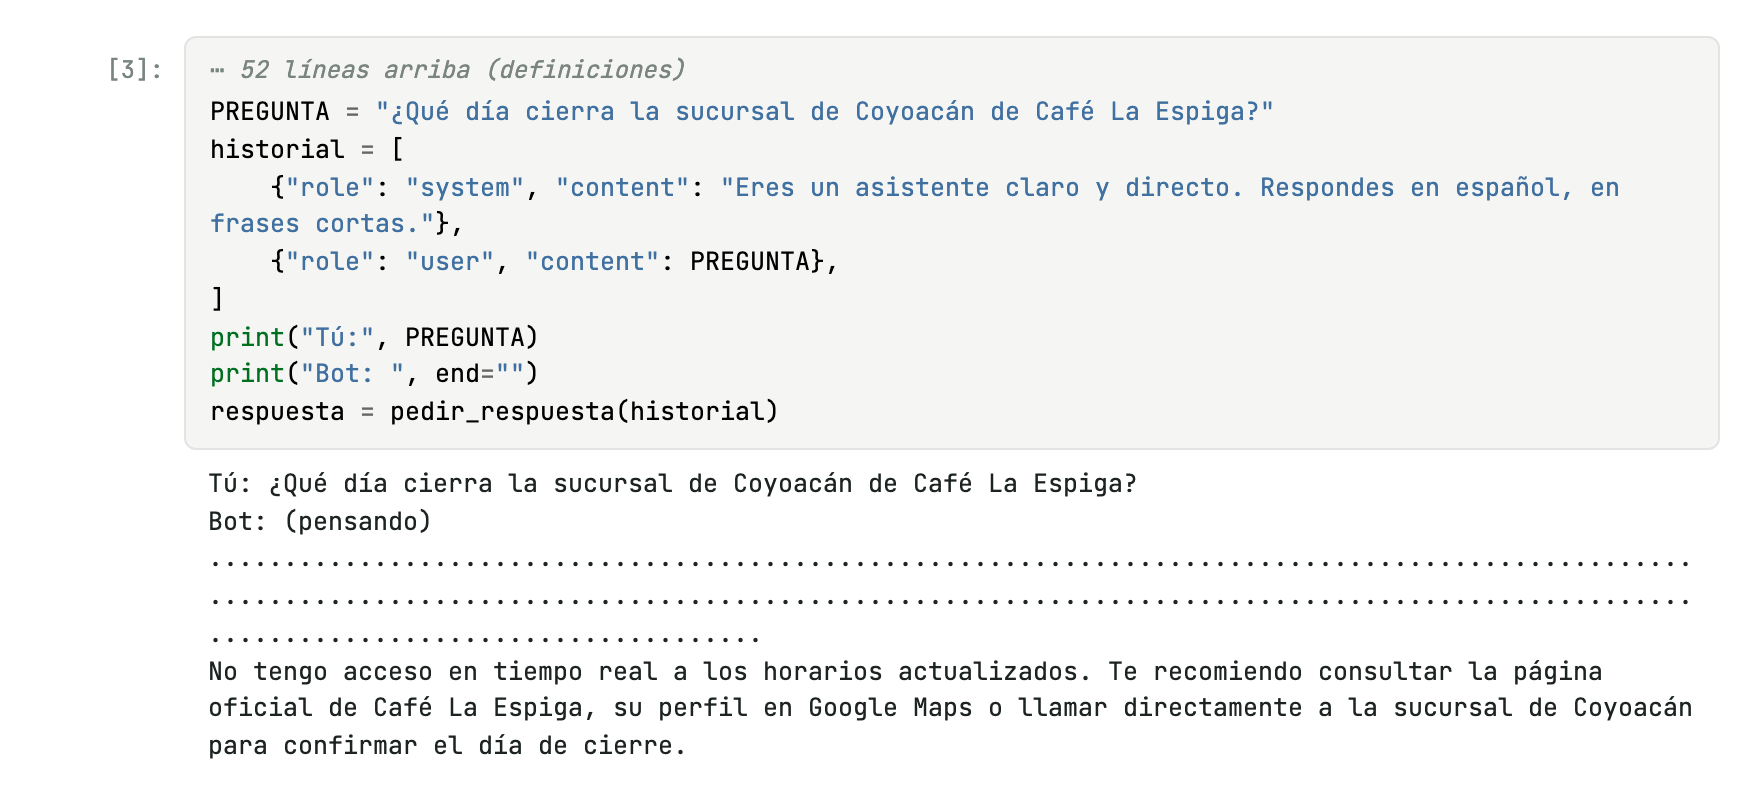
La pregunta es sobre Café La Espiga, una cafetería inventada para el taller. El modelo nunca leyó nada sobre ella. A veces inventa una respuesta con toda seguridad. Esta vez admitió que no sabía y mandó a buscar en Google Maps.
Pasos 3 y 4Cuatro documentos, once fichas
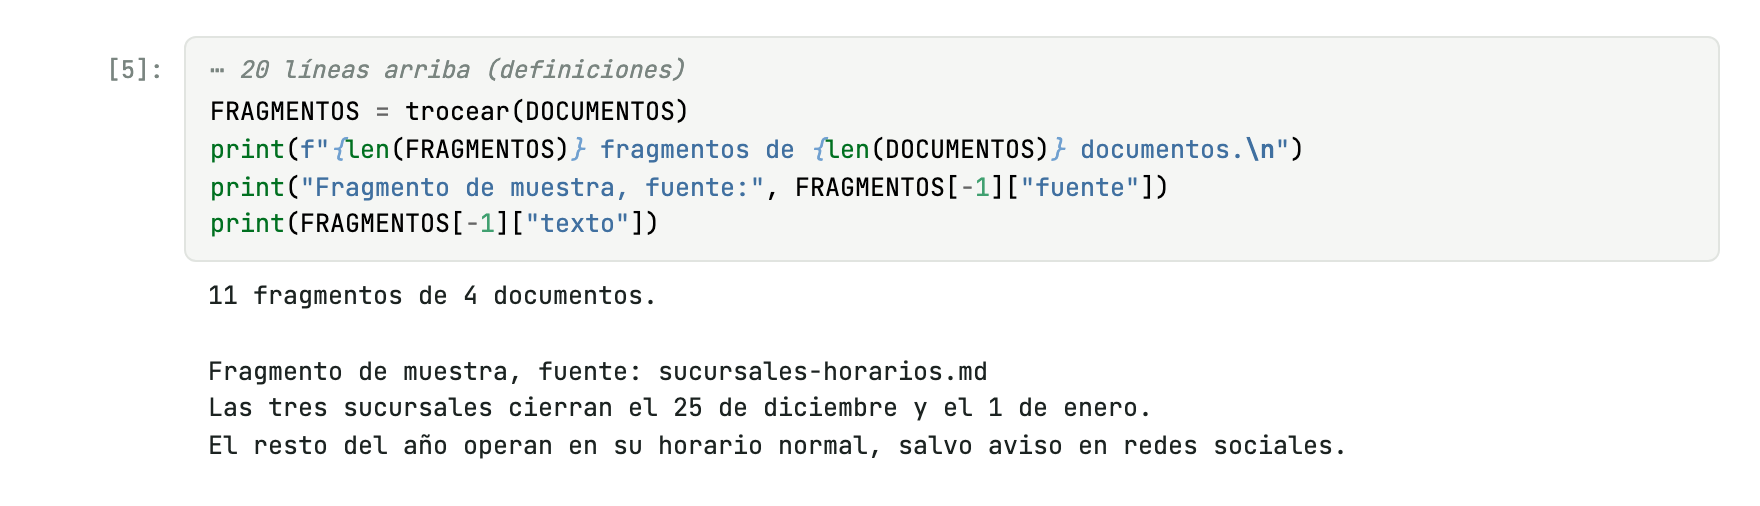
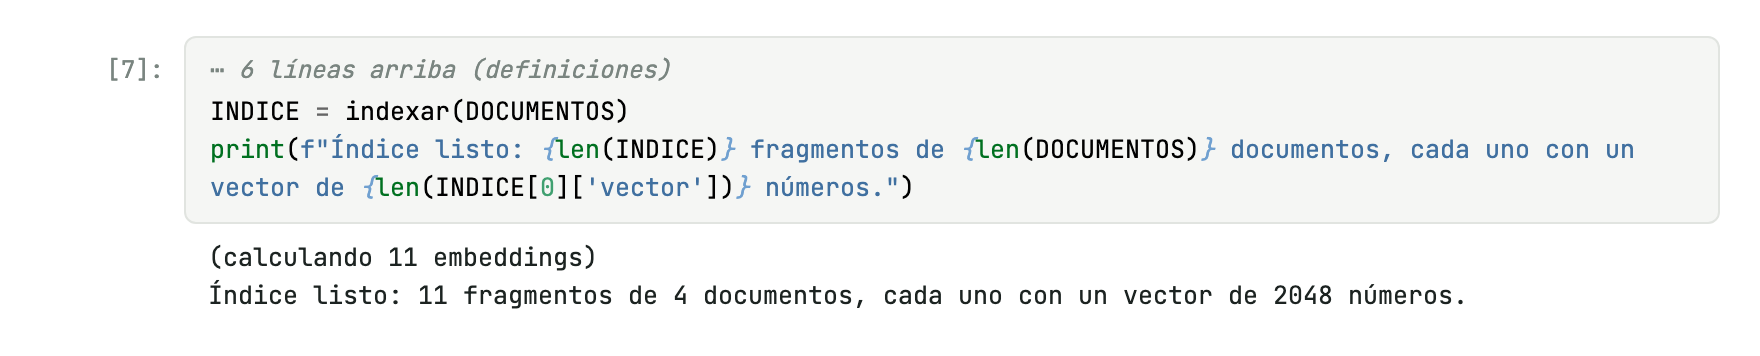
El corpus son cuatro documentos del café: menú, pagos y facturación, preguntas frecuentes, sucursales y horarios. Cada uno se corta en fichas de hasta 500 caracteres, sin partir párrafos. Cada ficha conserva el nombre de su documento. Ese nombre es la cita.
Paso 5Buscar por significado, no por palabras
Un embedding convierte una frase en una lista de números, un vector. Este modelo usa 2,048 números por frase. Las frases que dicen lo mismo quedan cerca, aunque usen palabras distintas.
"¿Puedo entrar con mi perro?" quedó cerca de la frase sobre mascotas, con 0.37. Quedó lejos del precio del latte, con 0.06, y del horario de Coyoacán, con 0.04. Ninguna frase dice "perro".
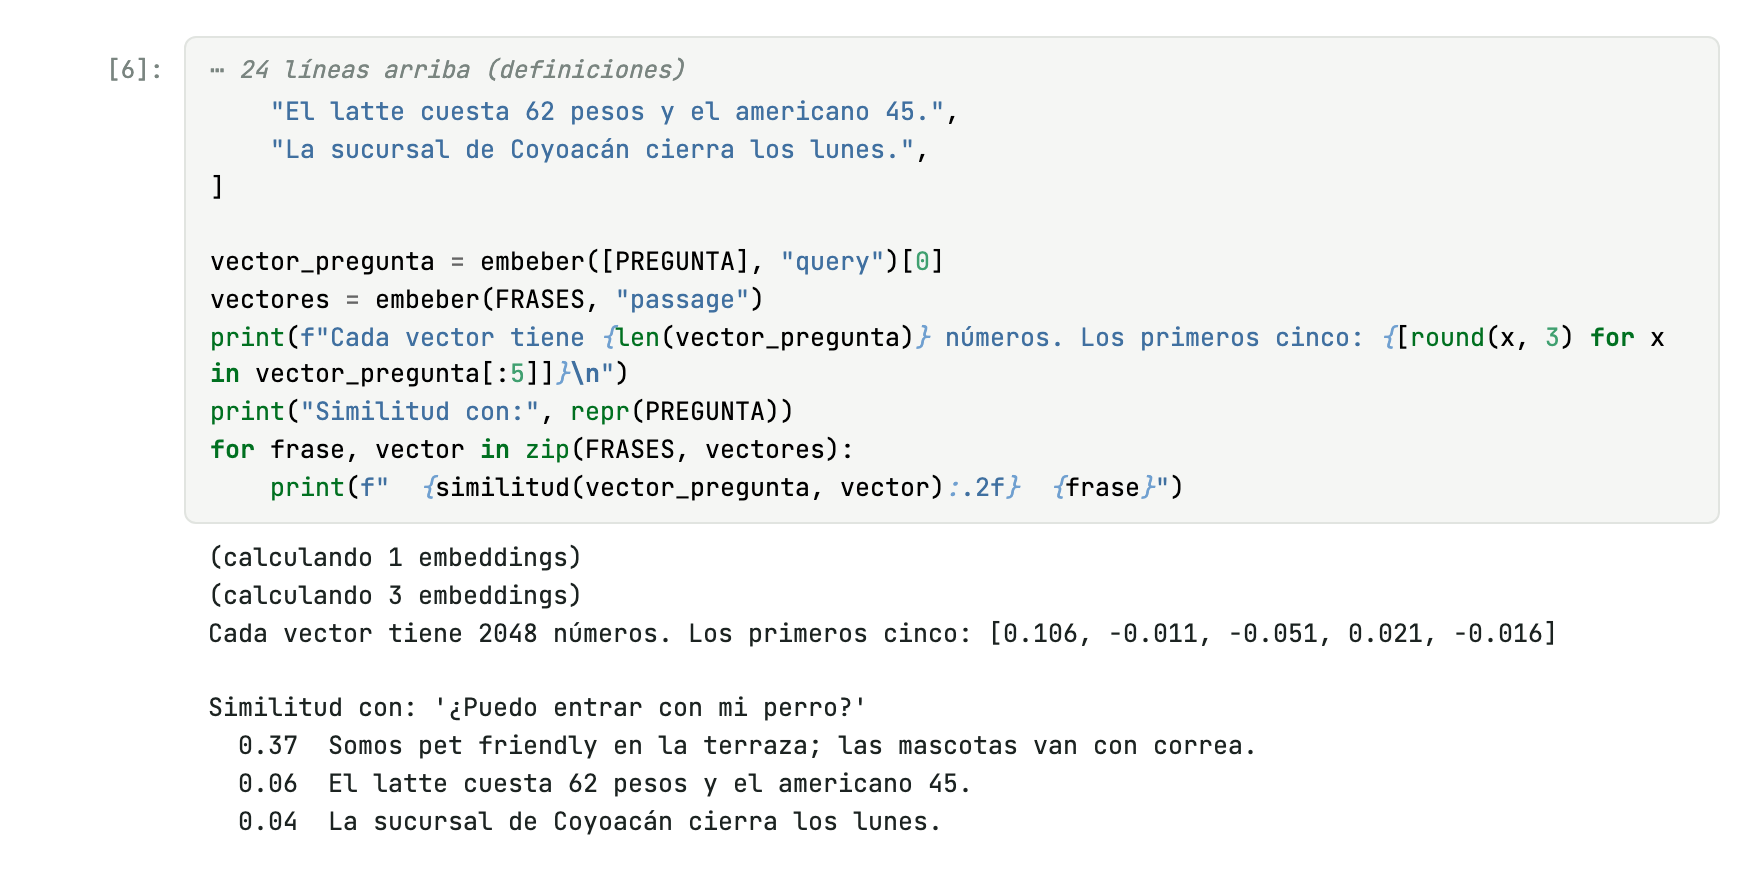
Este modelo distingue entre preguntas y documentos. La pregunta se embebe como query y las fichas como passage. El puntaje sirve para ordenar resultados, no como calificación absoluta.
Pasos 6 y 7La base de datos vectorial es una lista
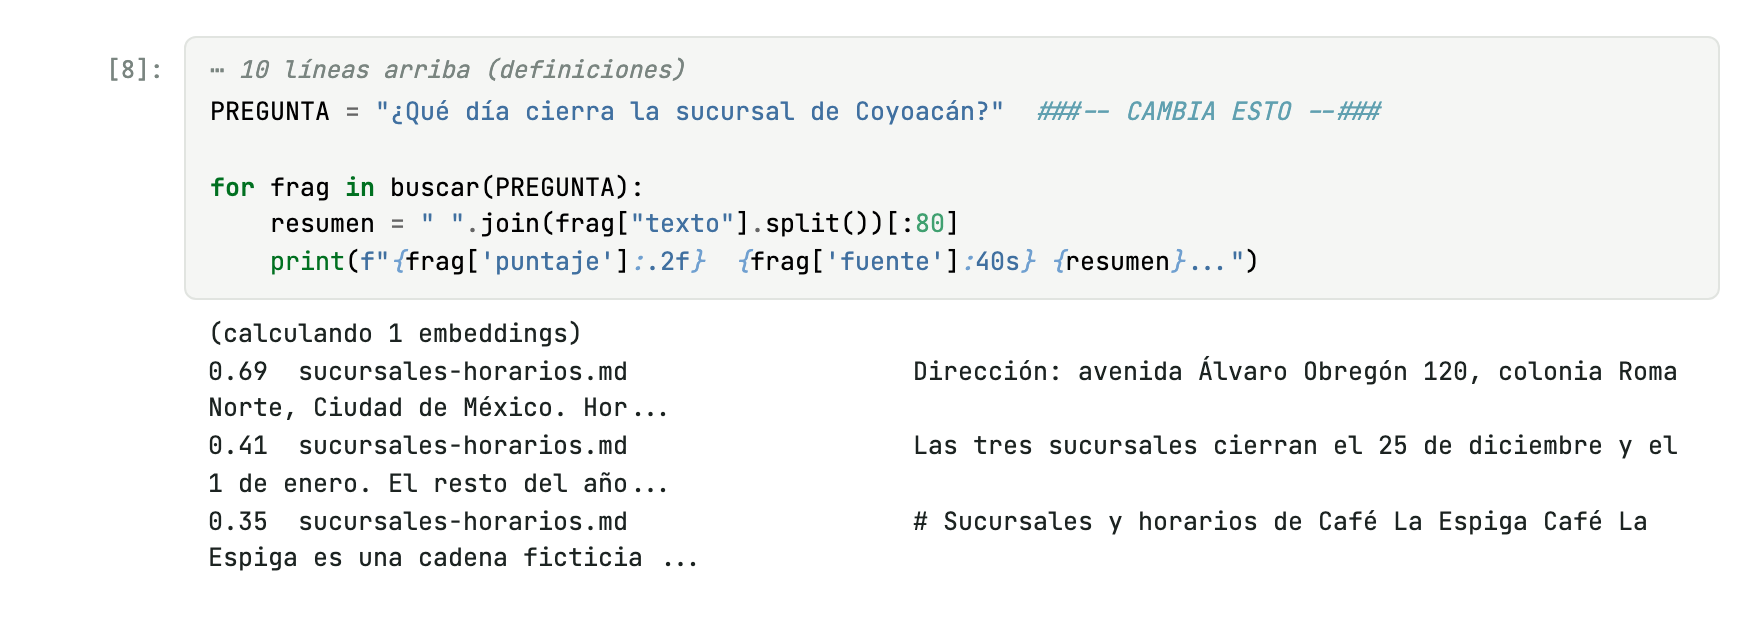
El índice guarda tres cosas por ficha: su texto, su fuente y su vector. Se calcula una sola vez. Buscar es comparar el vector de la pregunta contra el de cada ficha y quedarse con las tres más cercanas.
Paso 8Responder con cita
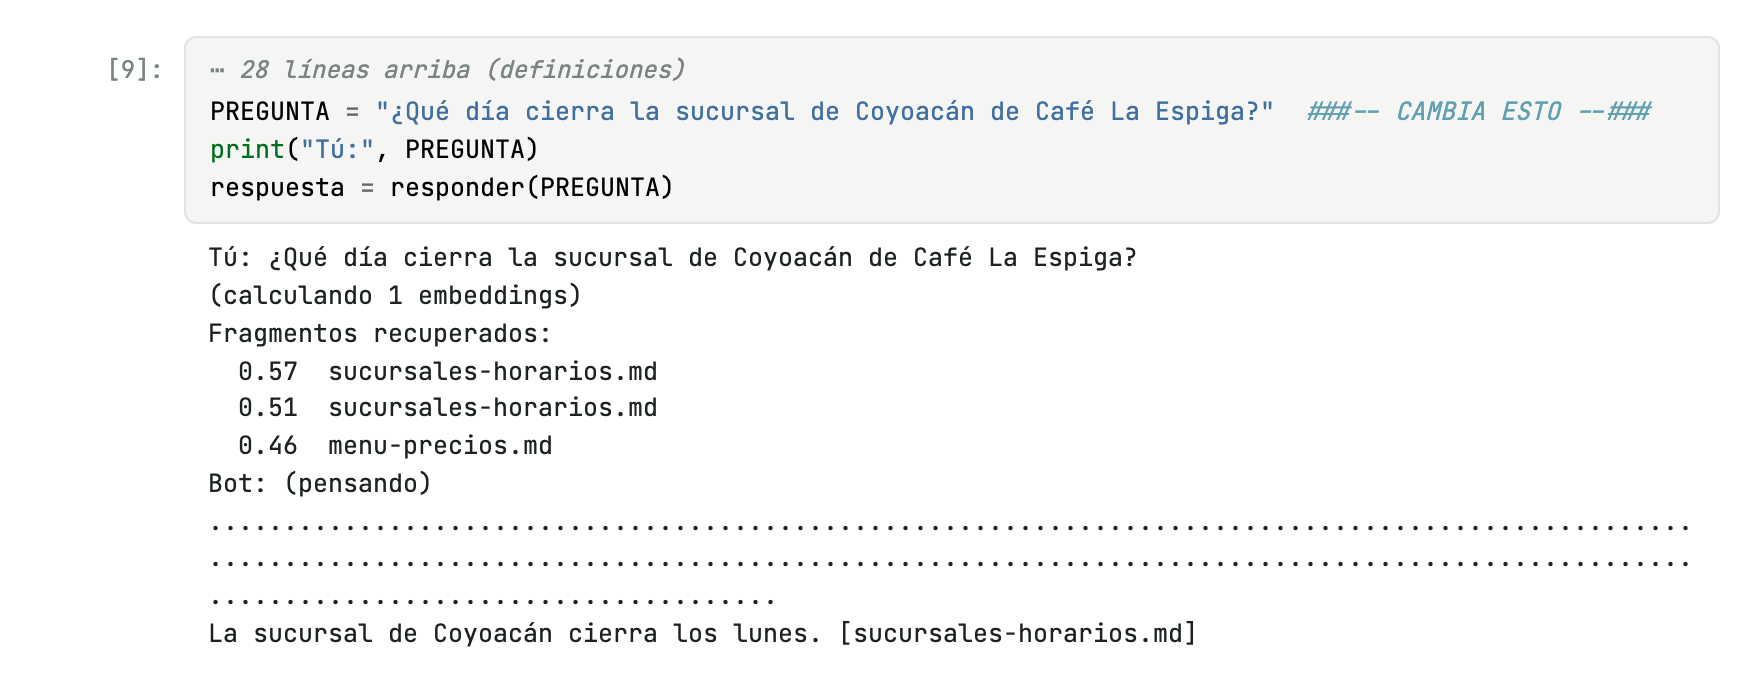
Las tres fichas se le ponen enfrente al modelo, cada una con su fuente. Es un examen a libro abierto. Las reglas van en el system prompt: contesta solo con el contexto, cita entre corchetes y, si no está, dilo.
La misma pregunta que el modelo no supo contestar en el paso 2 ahora sale bien, con su cita.
Paso 9Lo que no está, no se inventa
"¿Venden pizza?" no viene en ningún documento. La búsqueda trae tres fichas de todos modos, con puntajes bajos: 0.19, 0.18 y 0.17. El modelo las lee y responde "No encuentro eso en los documentos."
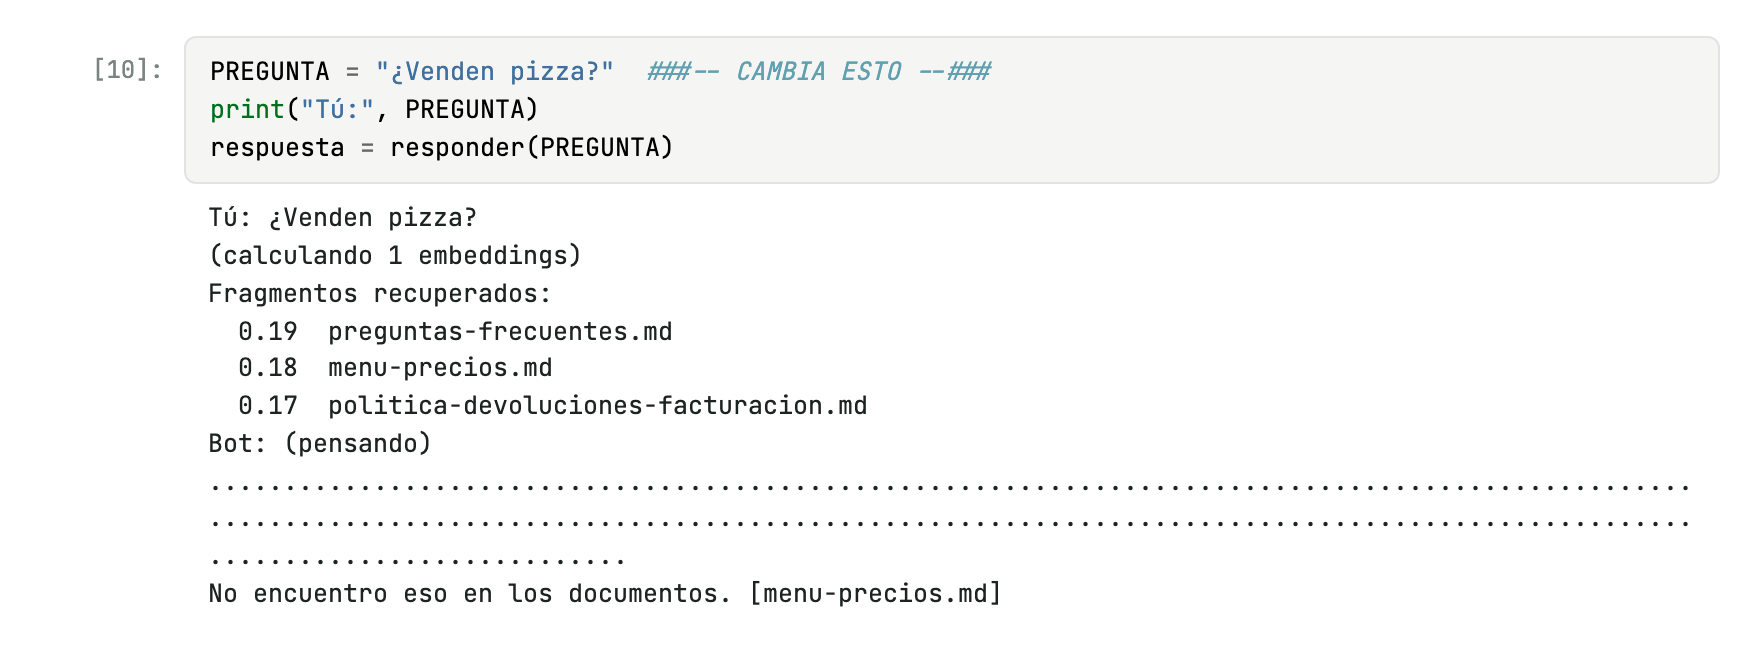
menu-precios.md, porque la regla le pide citar siempre.No hay un umbral de puntaje que separe lo que está de lo que no. Quien decide es el modelo, al leer. Y las reglas del prompt se cumplen al pie de la letra: si pides citar siempre, cita hasta cuando no encontró nada.
Paso 10Tu propio documento
Pegas un texto tuyo o subes un archivo .txt. Se suma a los documentos y se reconstruye el índice. No tocas ningún otro paso. El ejemplo usa la descripción de este mismo programa de talleres.
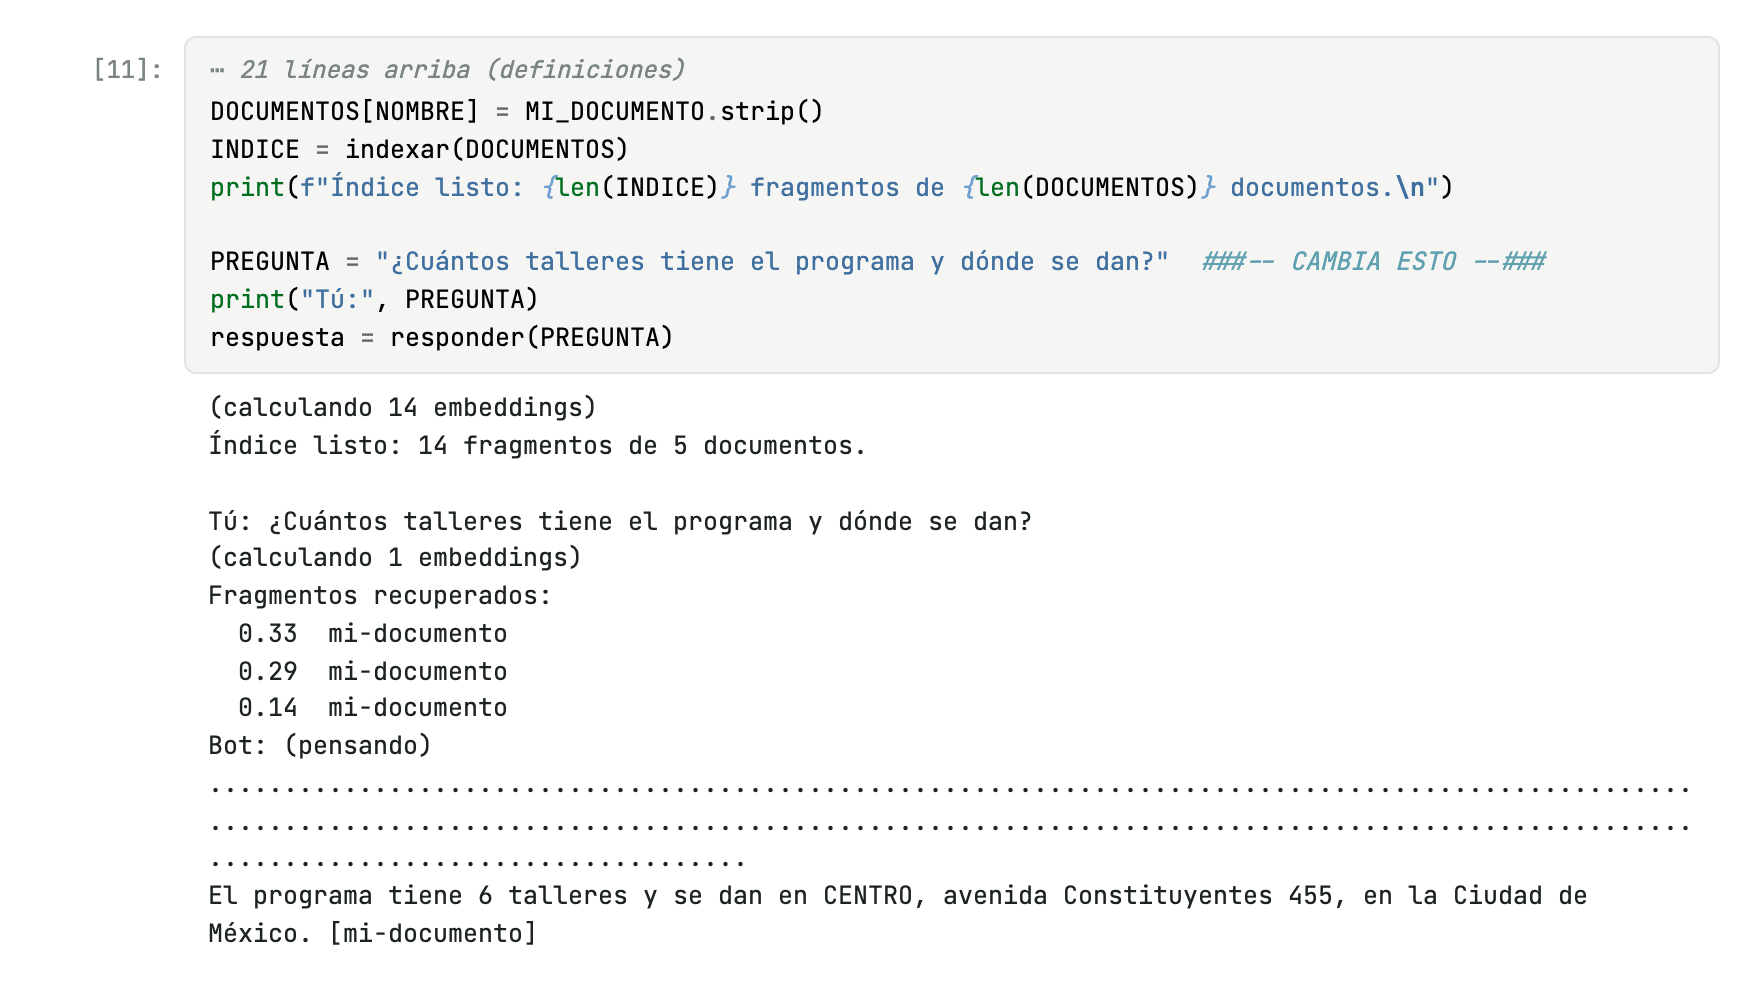
[mi-documento].Paso 11Platicar con tus documentos
El chat junta la memoria de la primera entrega con la búsqueda de esta. En cada turno busca tres fichas y responde con ellas. Las dos respuestas fueron correctas: Roma abre a las 8:00 y Coyoacán es la que cierra los lunes.
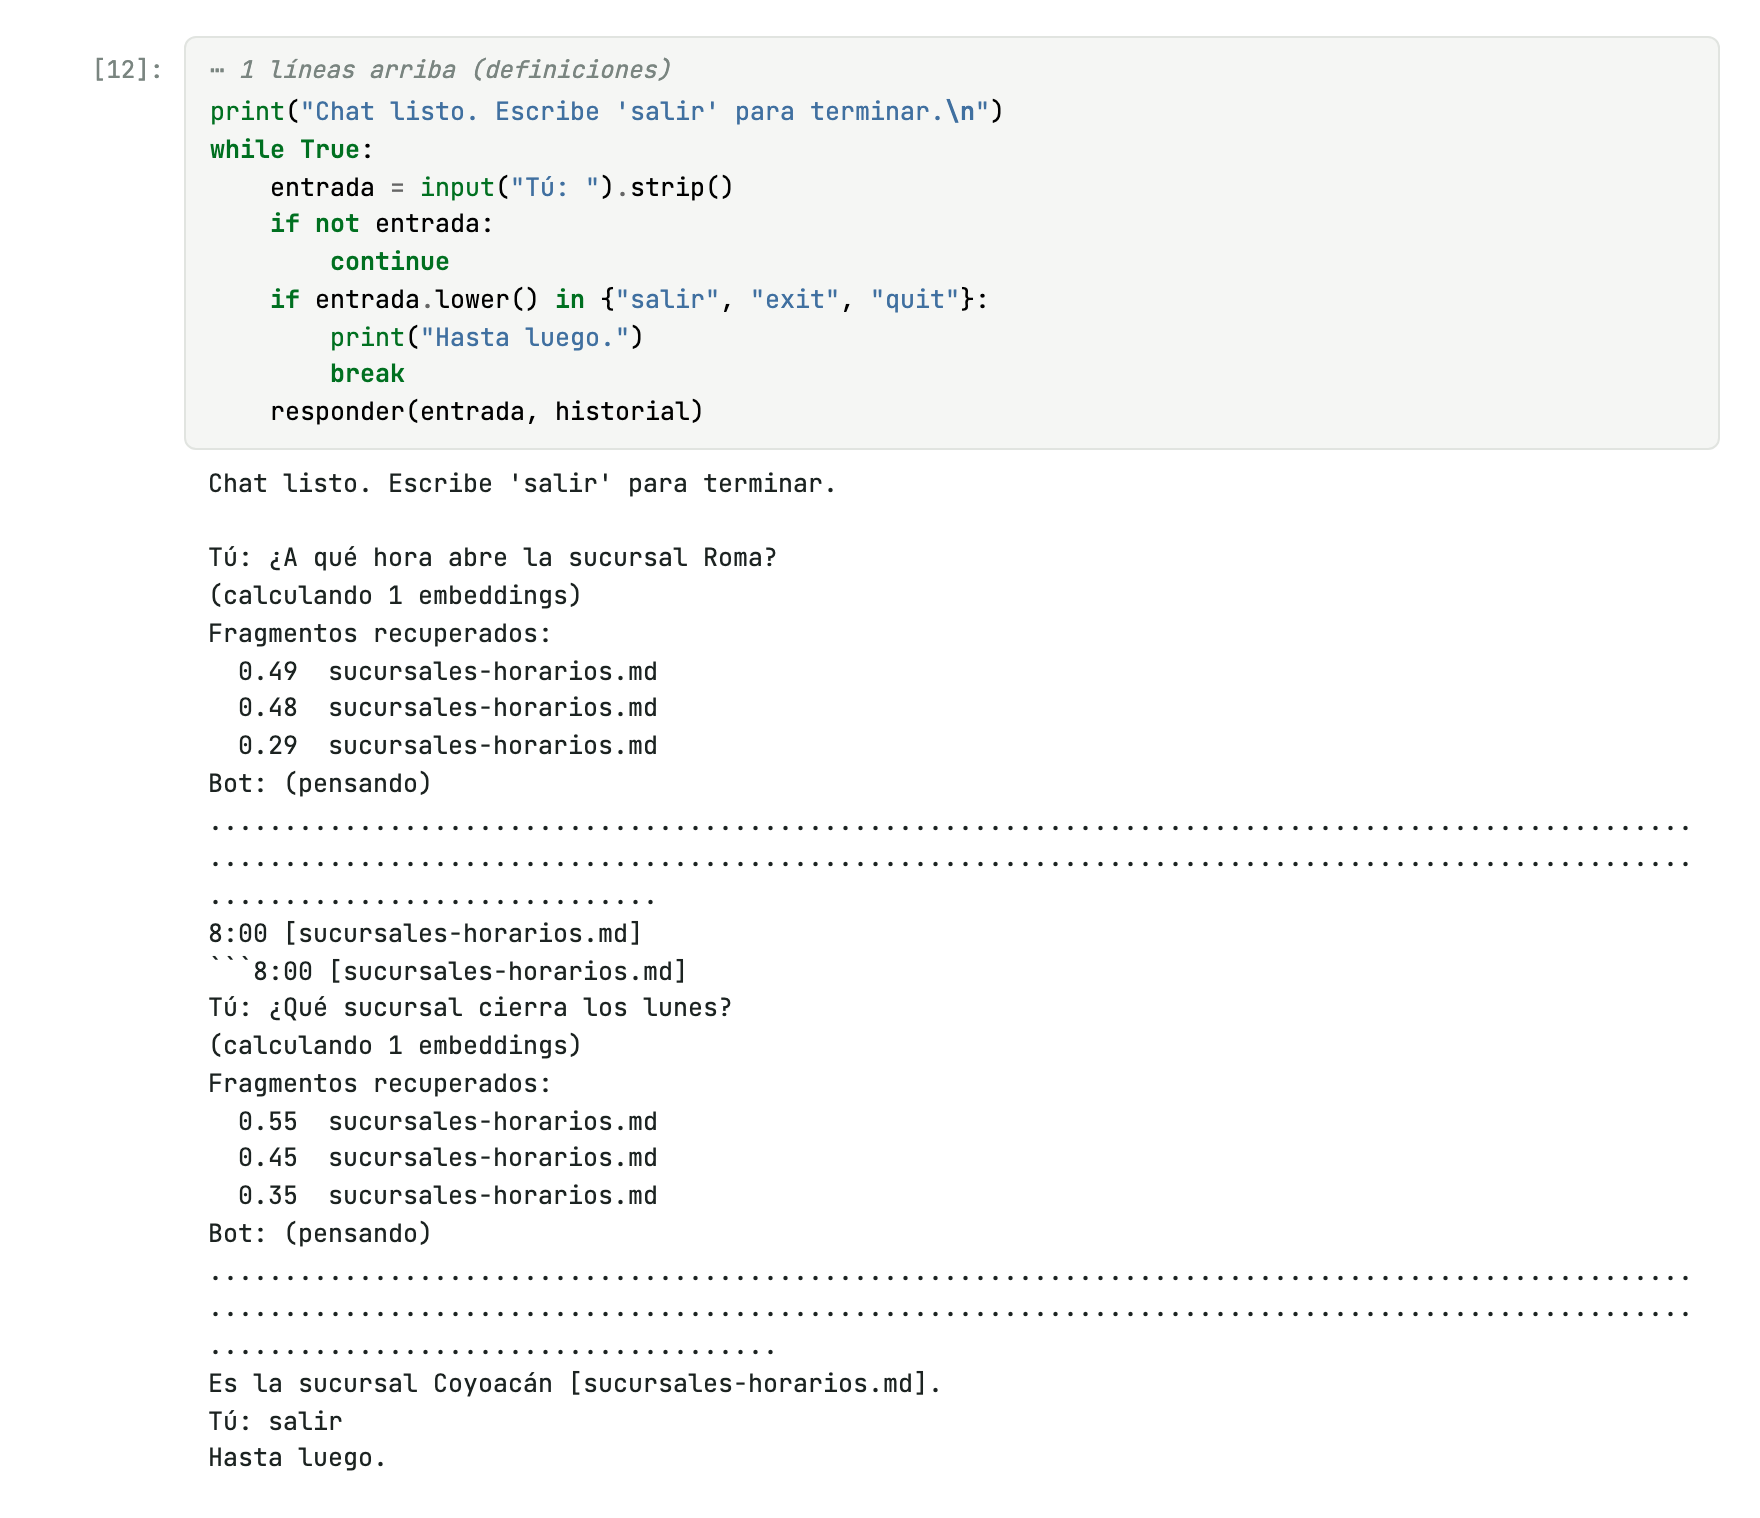
La búsqueda solo lee tu último mensaje. Si escribes "¿Y los domingos?", no sabe de qué sucursal hablas. Resolverlo bien implica reescribir la pregunta con el historial, y eso ya es trabajo de un agente.
- El modelo solo sabe lo que vio en su entrenamiento. Tus documentos no estaban ahí.
- Un embedding pone cerca los textos que significan lo mismo.
- Tu base de datos vectorial es una lista de fichas con su vector. Buscar es comparar vectores.
- RAG: tu código busca, el modelo redacta con lo que recibe y cita la fuente.