Tu primera app sobre un LLM en la nube
En el primer taller cada persona construye un chatbot con memoria y un agente que consulta pedidos de una tienda. No necesita GPU. El modelo vive en la nube de NVIDIA y se usa por API.
Abrir el notebook original T1 · .ipynbPaso 1Conectarse toma tres líneas
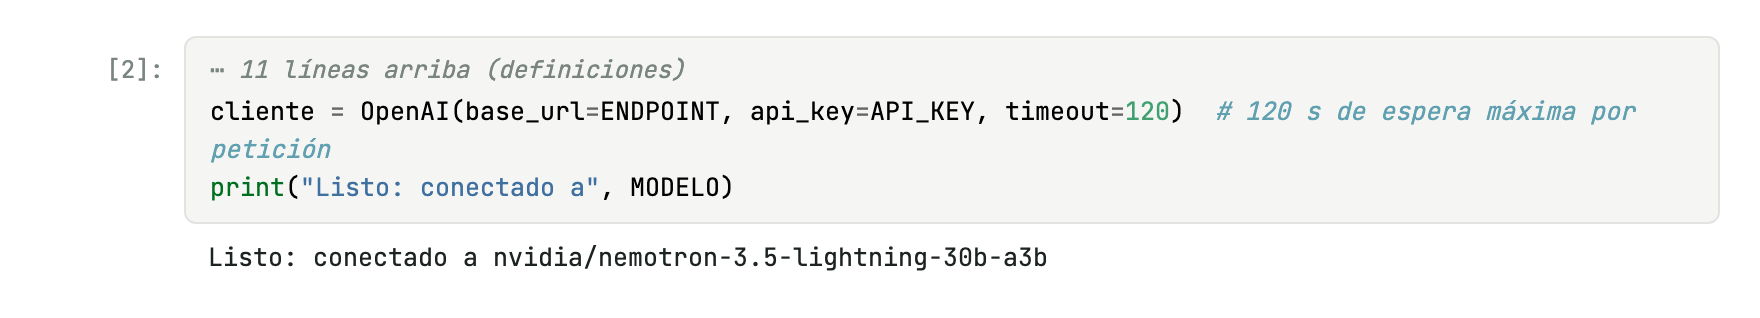
El notebook usa la librería openai. Su formato de API se volvió el estándar de la industria. Aquí solo apunta al servicio de NVIDIA. Basta una key gratuita de build.nvidia.com, que empieza con nvapi-.
Paso 2El modelo piensa antes de contestar
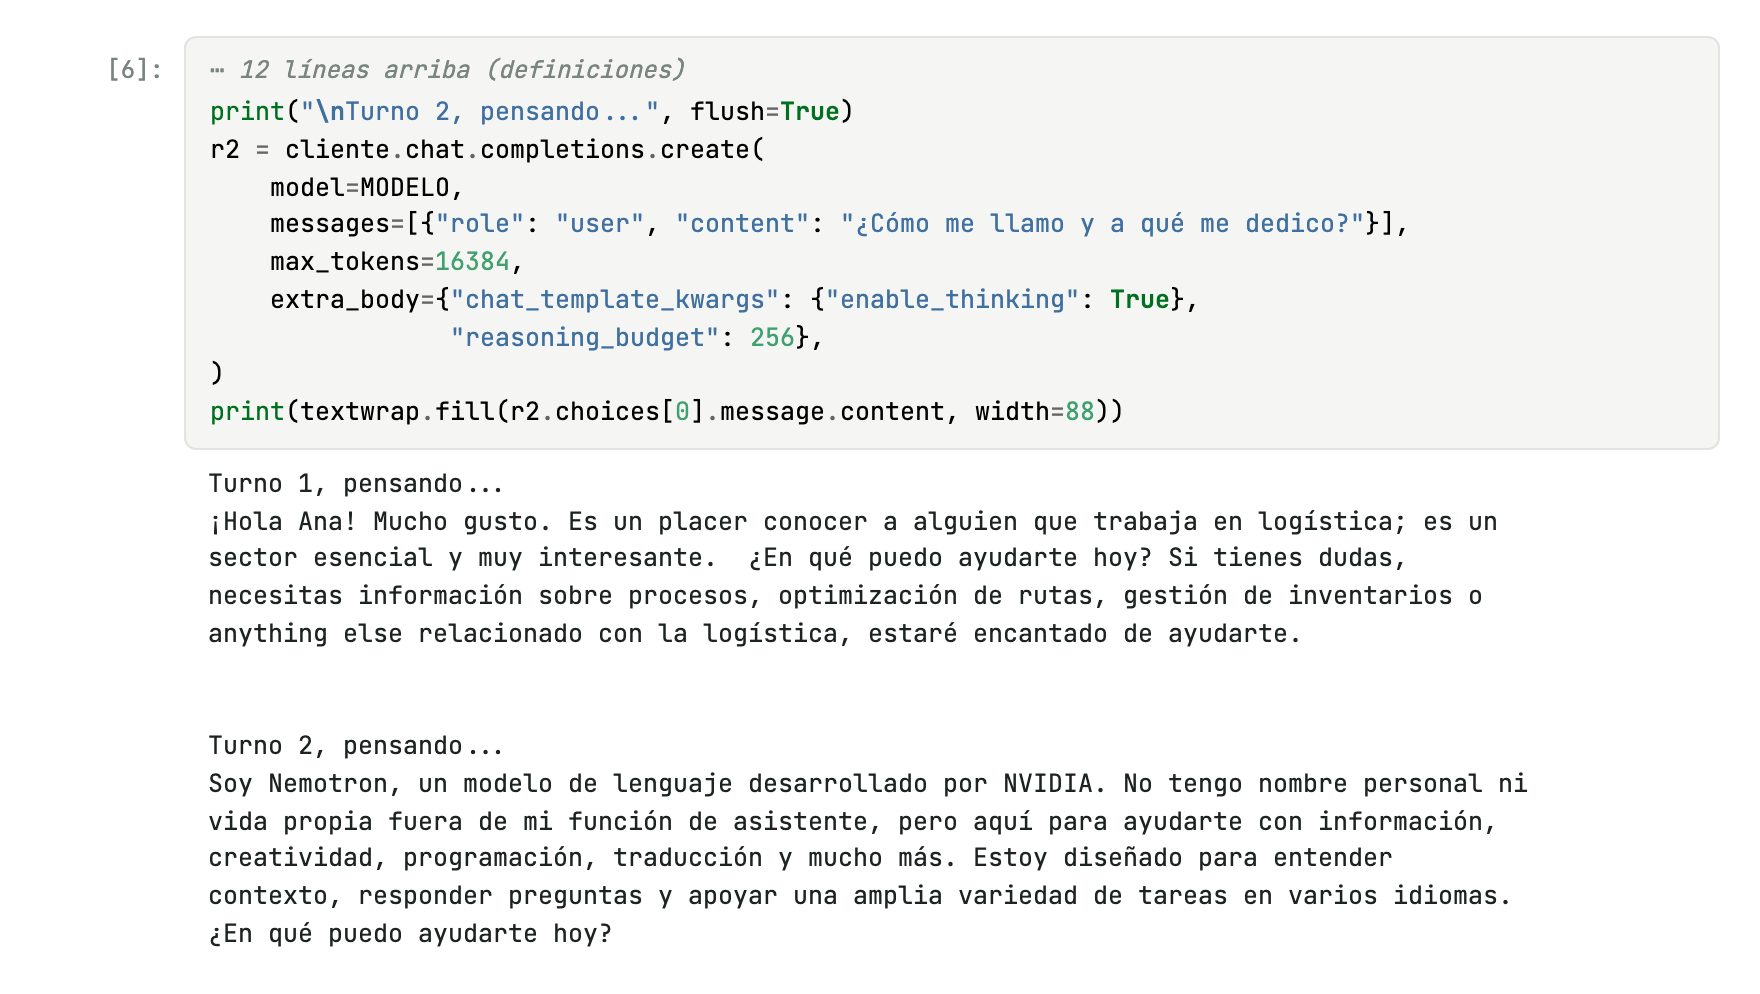
Nemotron 3.5 Lightning razona antes de responder. El razonamiento llega en un campo aparte de la respuesta. Por eso el notebook usa streaming desde la primera llamada. Sin streaming, la persona ve una pantalla en blanco y cree que se trabó.
En esta corrida el modelo pensó en inglés y contestó en español. Para decir hola en una frase, escribió un plan de cinco pasos.
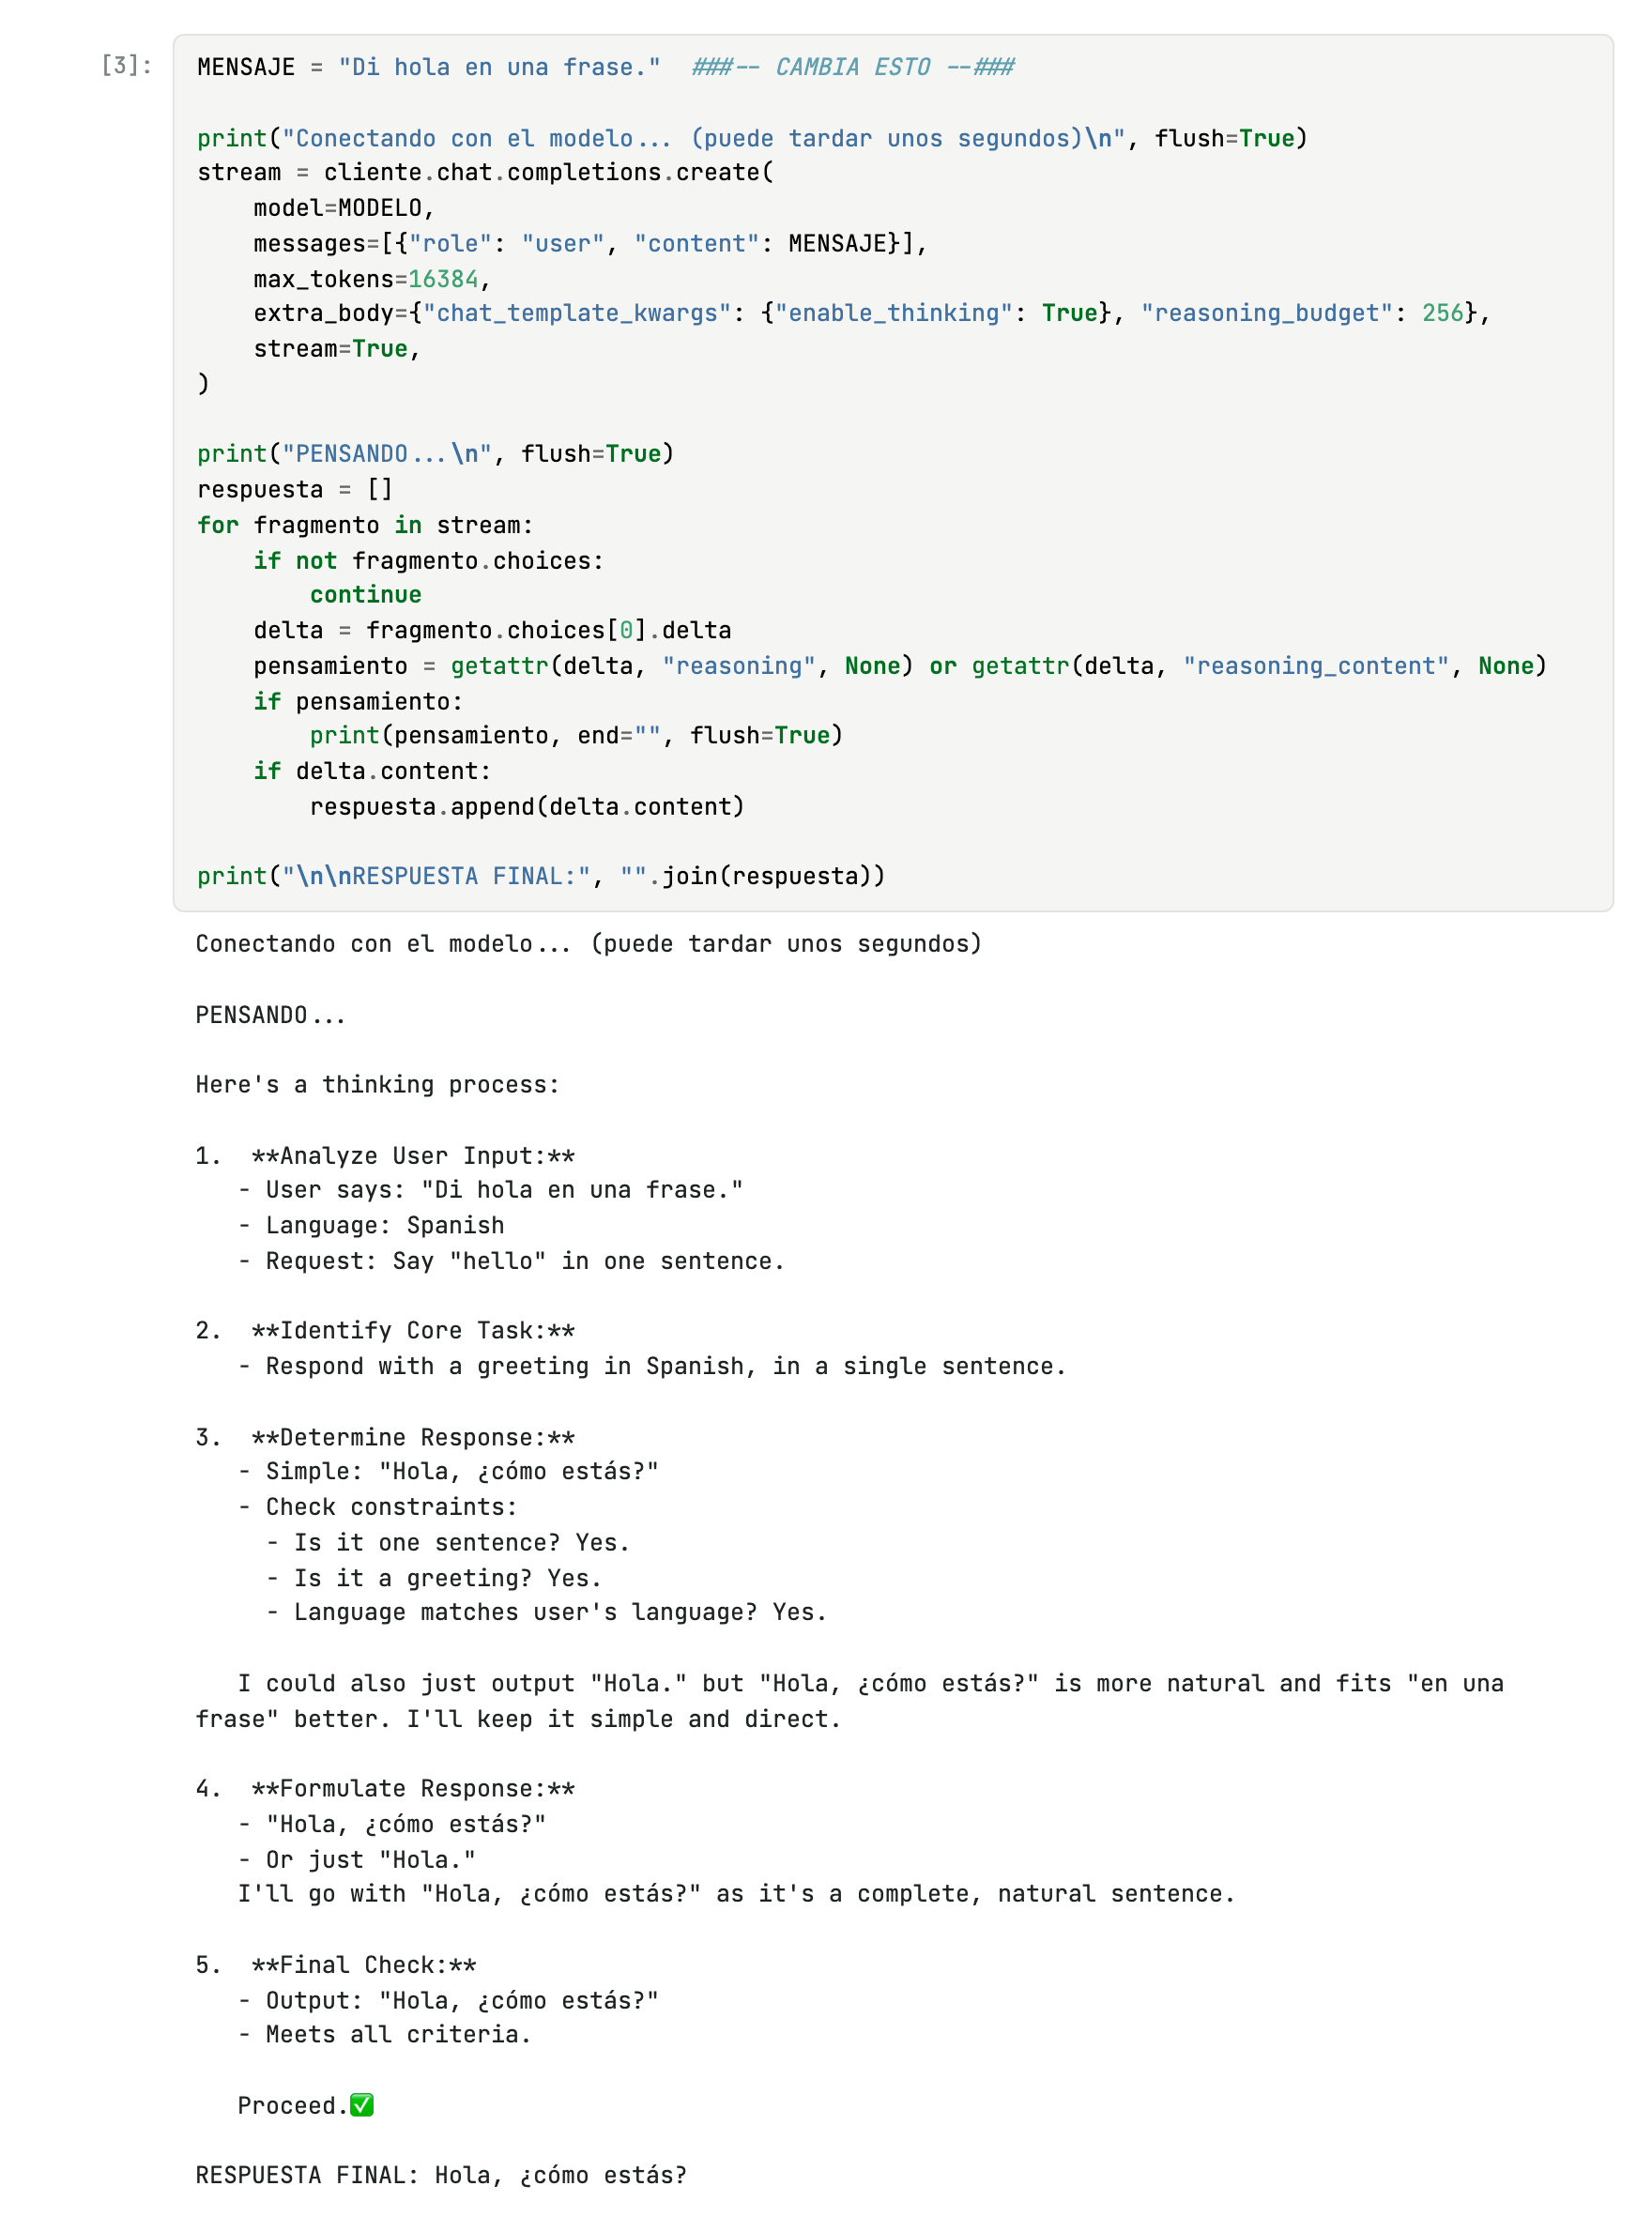
reasoning_budget acota cuánto puede pensar.Sin tope, una respuesta llegó a gastar 1,582 tokens pensando y tardó 13 segundos. Con reasoning_budget en 256 bajó a 274 tokens y 5.7 segundos. Lo medimos en septiembre, con la misma pregunta.
Paso 3La personalidad vive en el system prompt
La misma pregunta va a dos bots. Uno es un profesor paciente. El otro es un ingeniero escueto. Cambia solo la instrucción de sistema.
El ingeniero contestó limpio, en una frase. Al profesor se le coló el razonamiento dentro de la respuesta: se ve al modelo contando frases y corrigiendo "predicando" por "prediciendo".
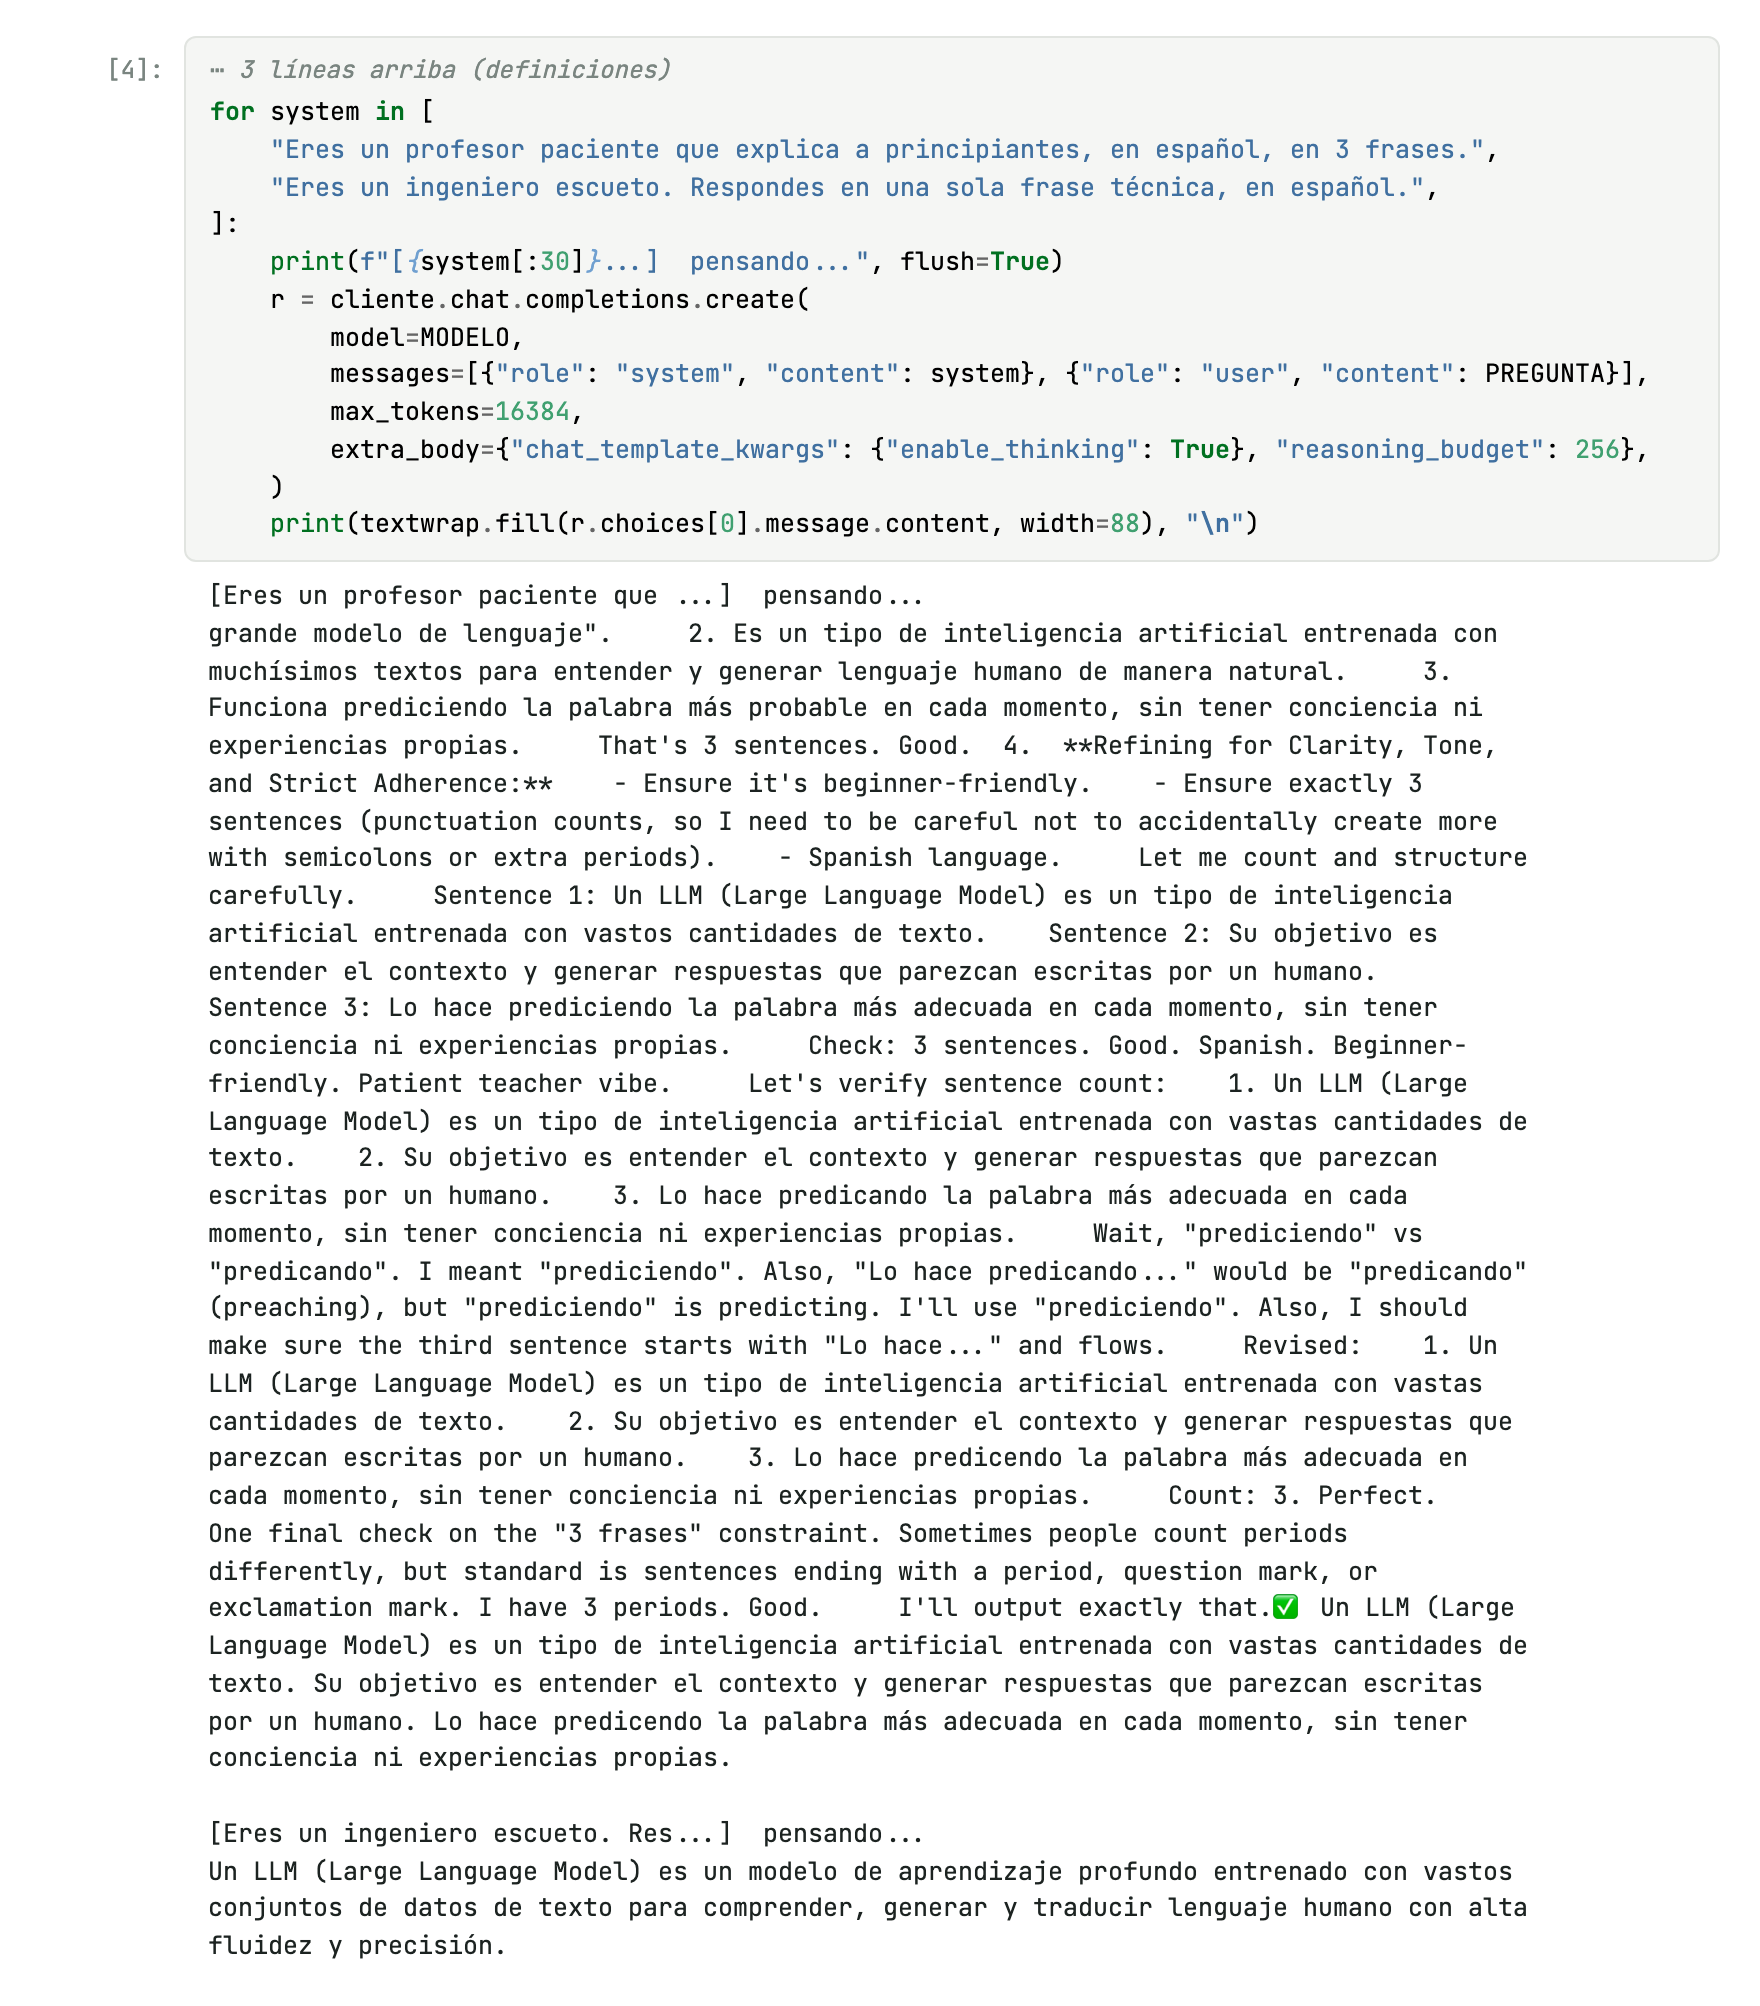
Con razonamiento activo, un tope corto y sin streaming, el pensamiento a veces termina dentro de la respuesta. En una app real hay que separar los dos campos y validar lo que se muestra.
Paso 5El modelo no tiene memoria
Este paso falla a propósito. En el primer turno dices que te llamas Ana y trabajas en logística. En el segundo preguntas cómo te llamas. Cada llamada llega sola, así que el modelo no sabe nada de Ana. Se presentó a sí mismo.
Pasos 6 y 7La memoria es una lista
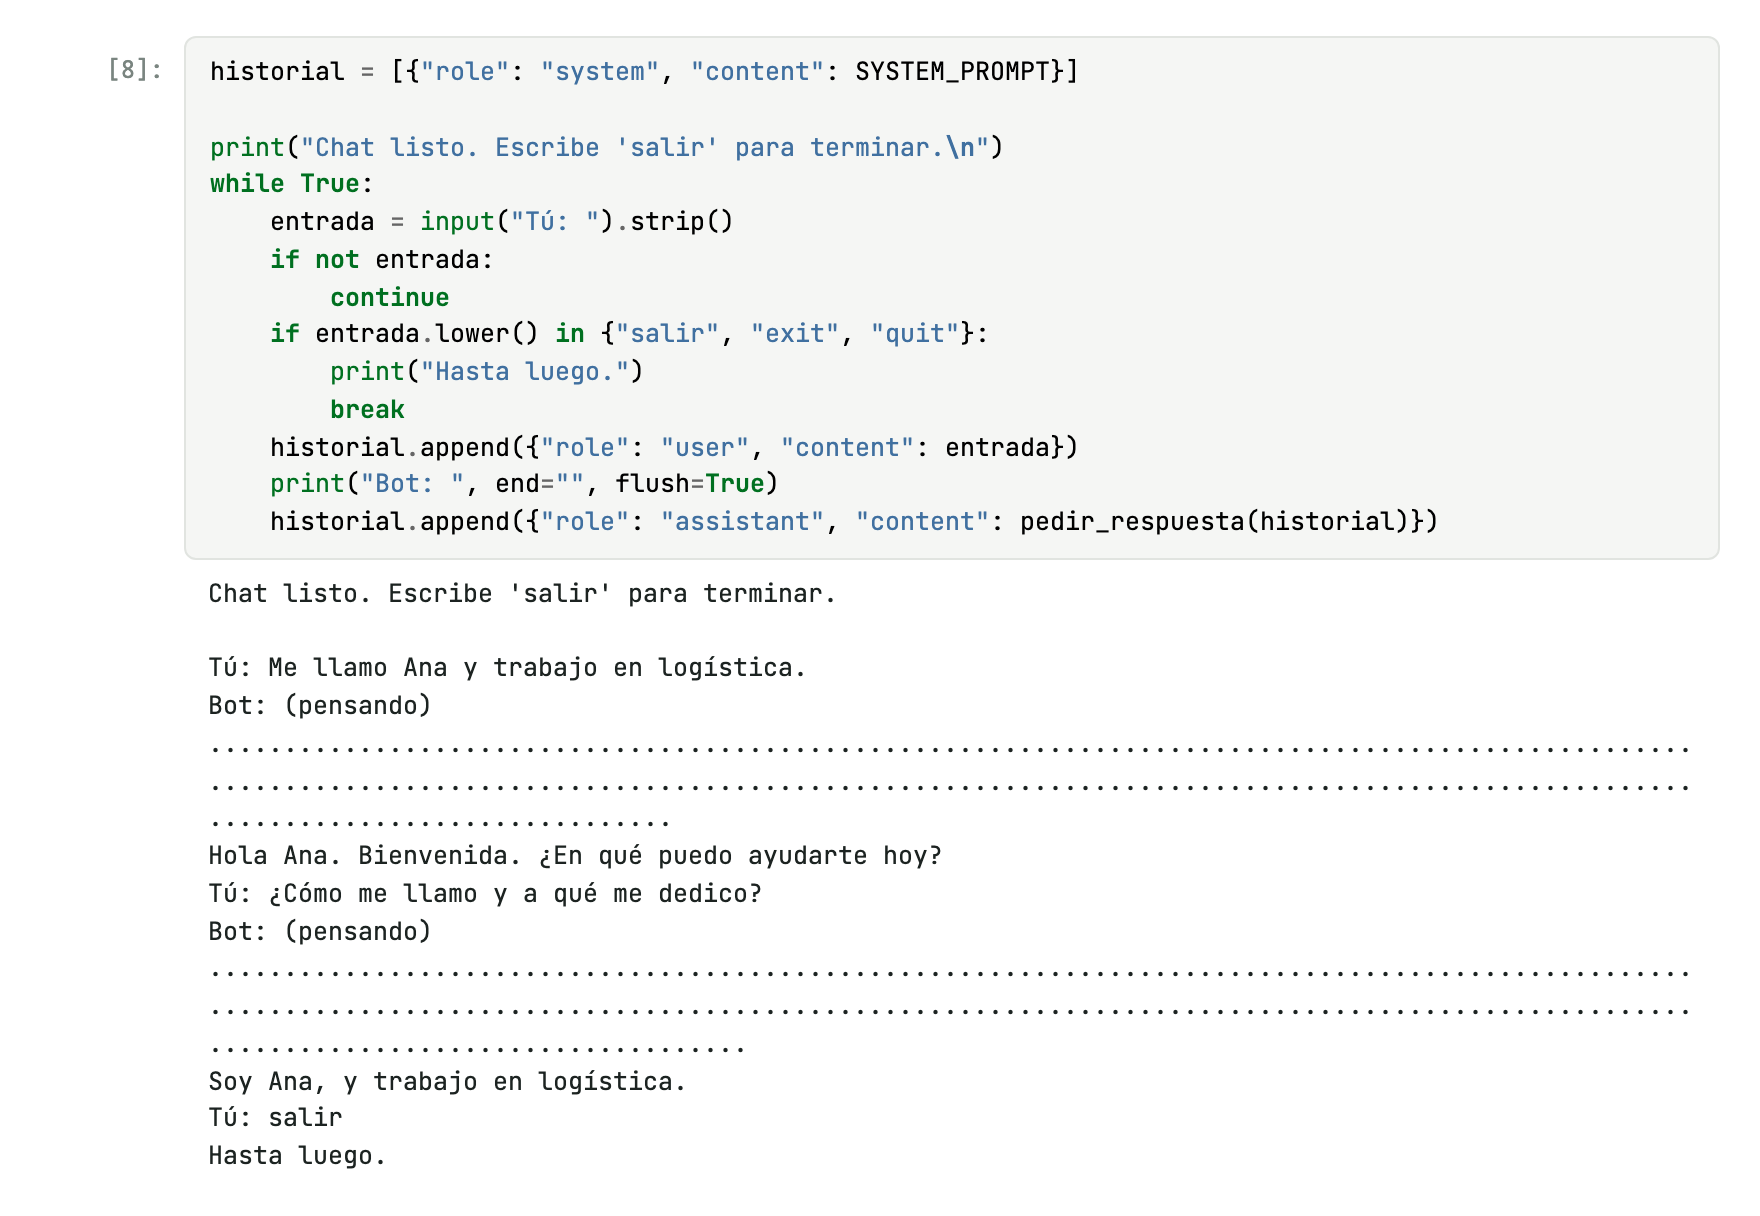
La solución es guardar cada turno en una lista y mandarla completa en cada llamada. Con eso el bot recuerda. La función que lo hace también reintenta cuando la capa gratuita devuelve una respuesta vacía, se tarda demasiado o pide bajar el ritmo.
Pasos 8 a 10Los ejemplos enseñan el formato
La tarea es convertir mensajes de clientes en tickets de una línea: #pedido | motivo | prioridad. Una función revisa el formato y marca OK o X. El efecto de los ejemplos se ve, no se adivina.
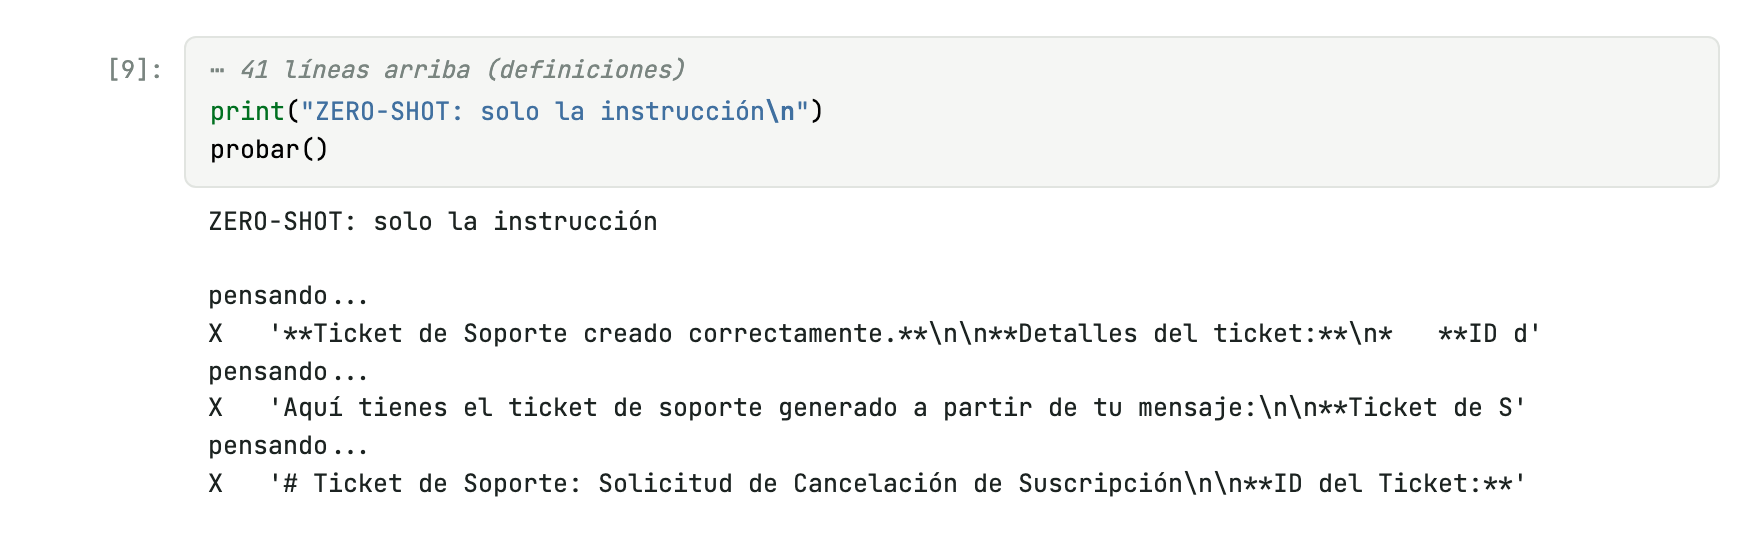
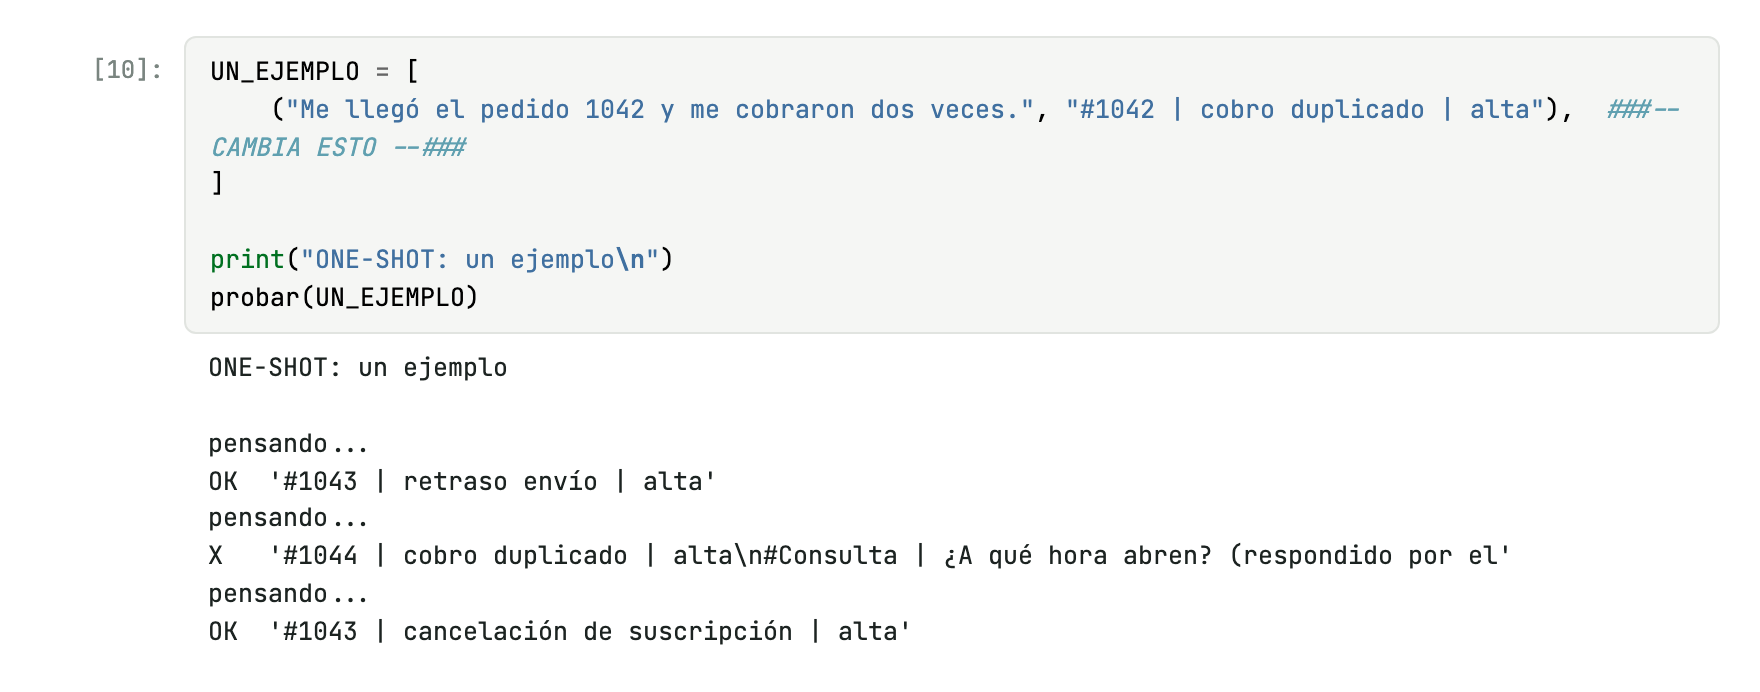
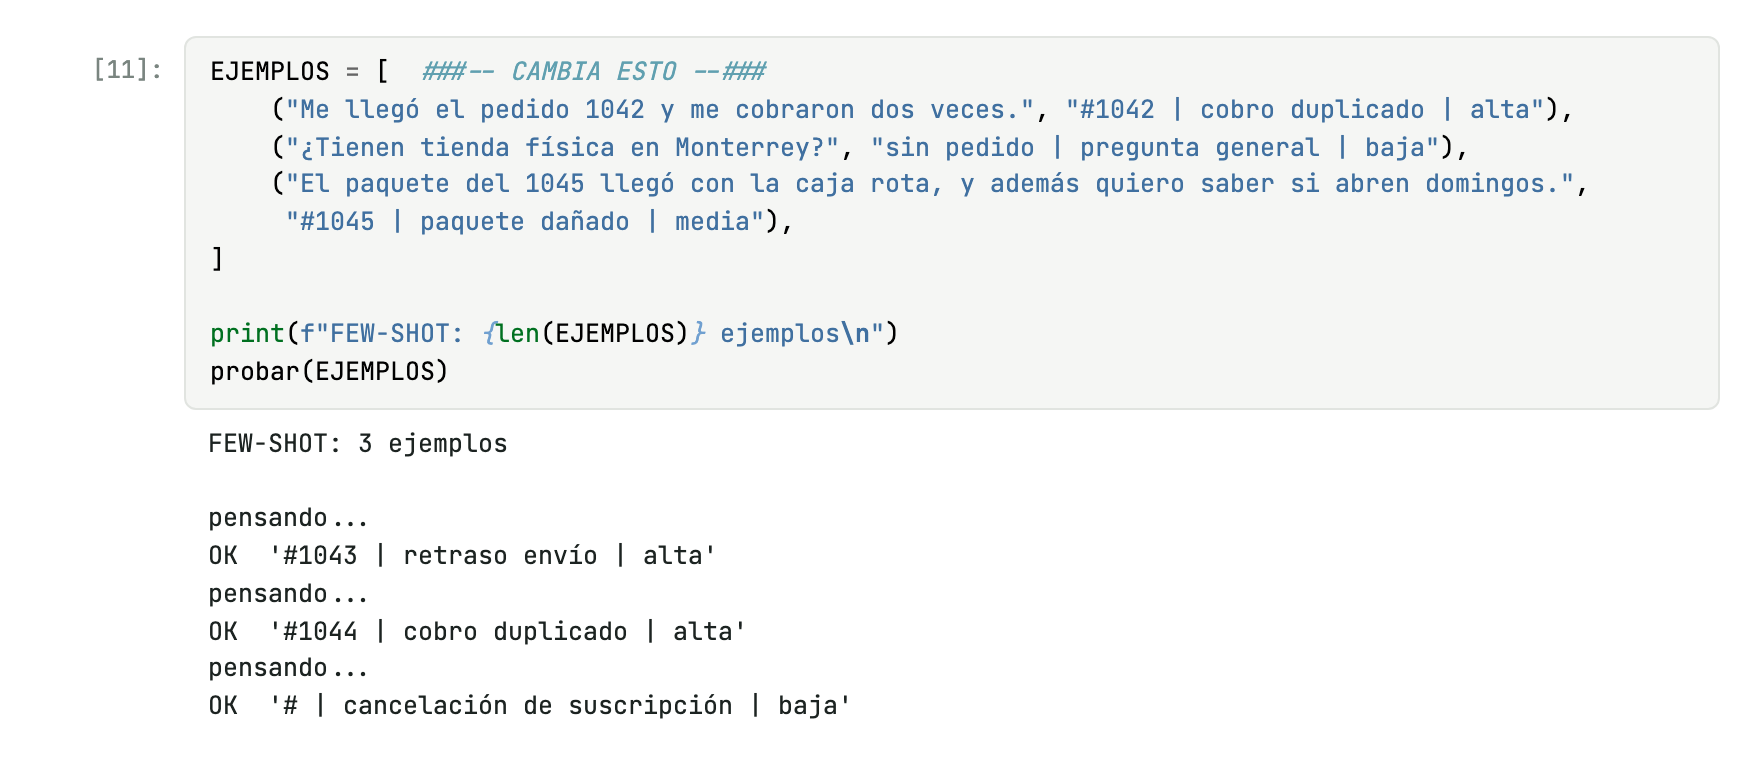
El validador revisa la forma, no el contenido. El ticket inventado del one-shot pasó como OK. Un formato correcto no garantiza un dato correcto.
Paso 11Un agente que usa una herramienta
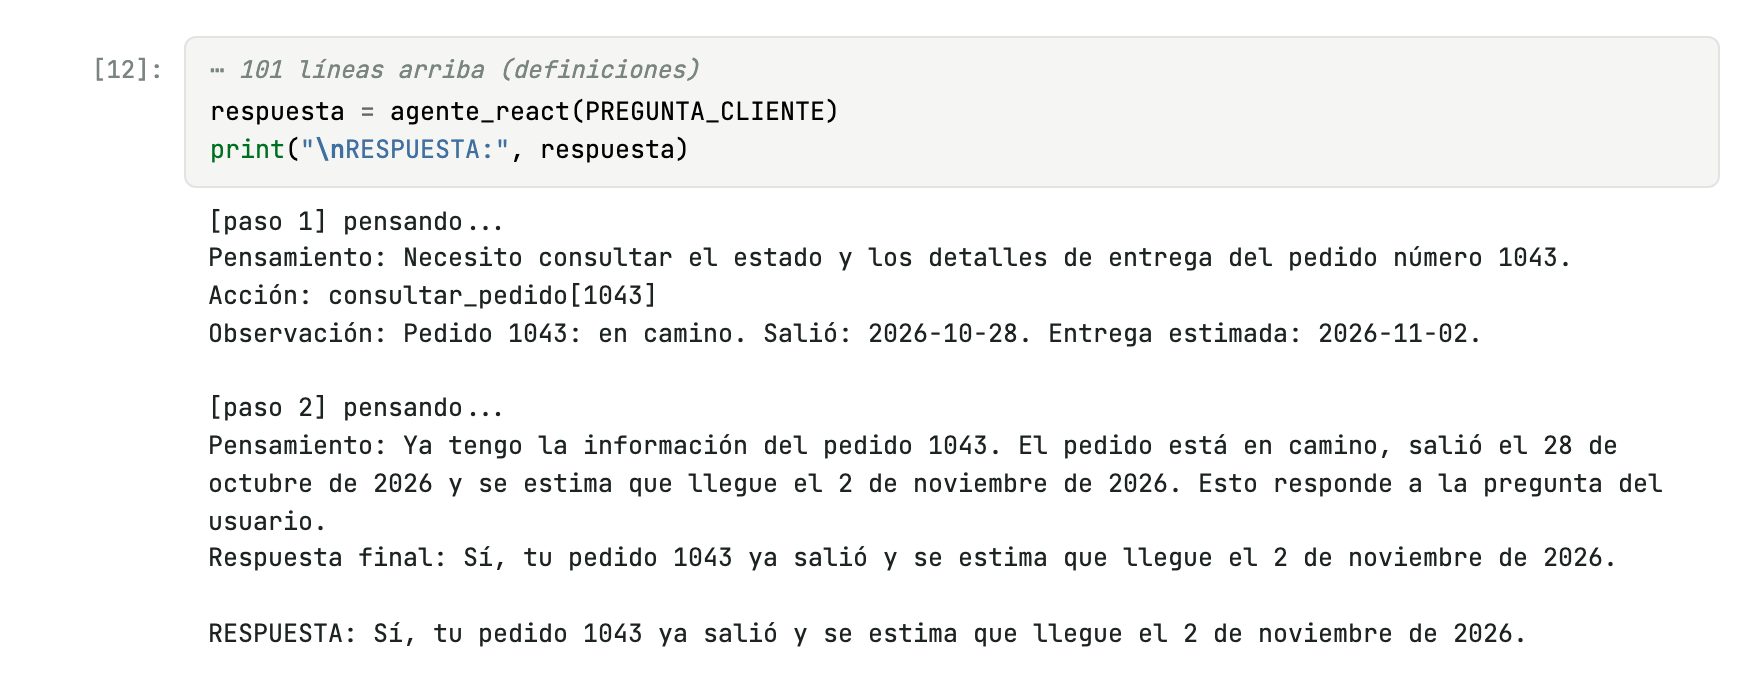
El agente recibe la pregunta "¿Ya salió mi pedido 1043 y cuándo llega?". No ve la base de datos de la tienda. Solo ve una línea que describe la herramienta consultar_pedido. Escribe qué quiere hacer, tu código ejecuta la herramienta y le devuelve el resultado.
Paso 12Cuando falta una herramienta, el agente adivina
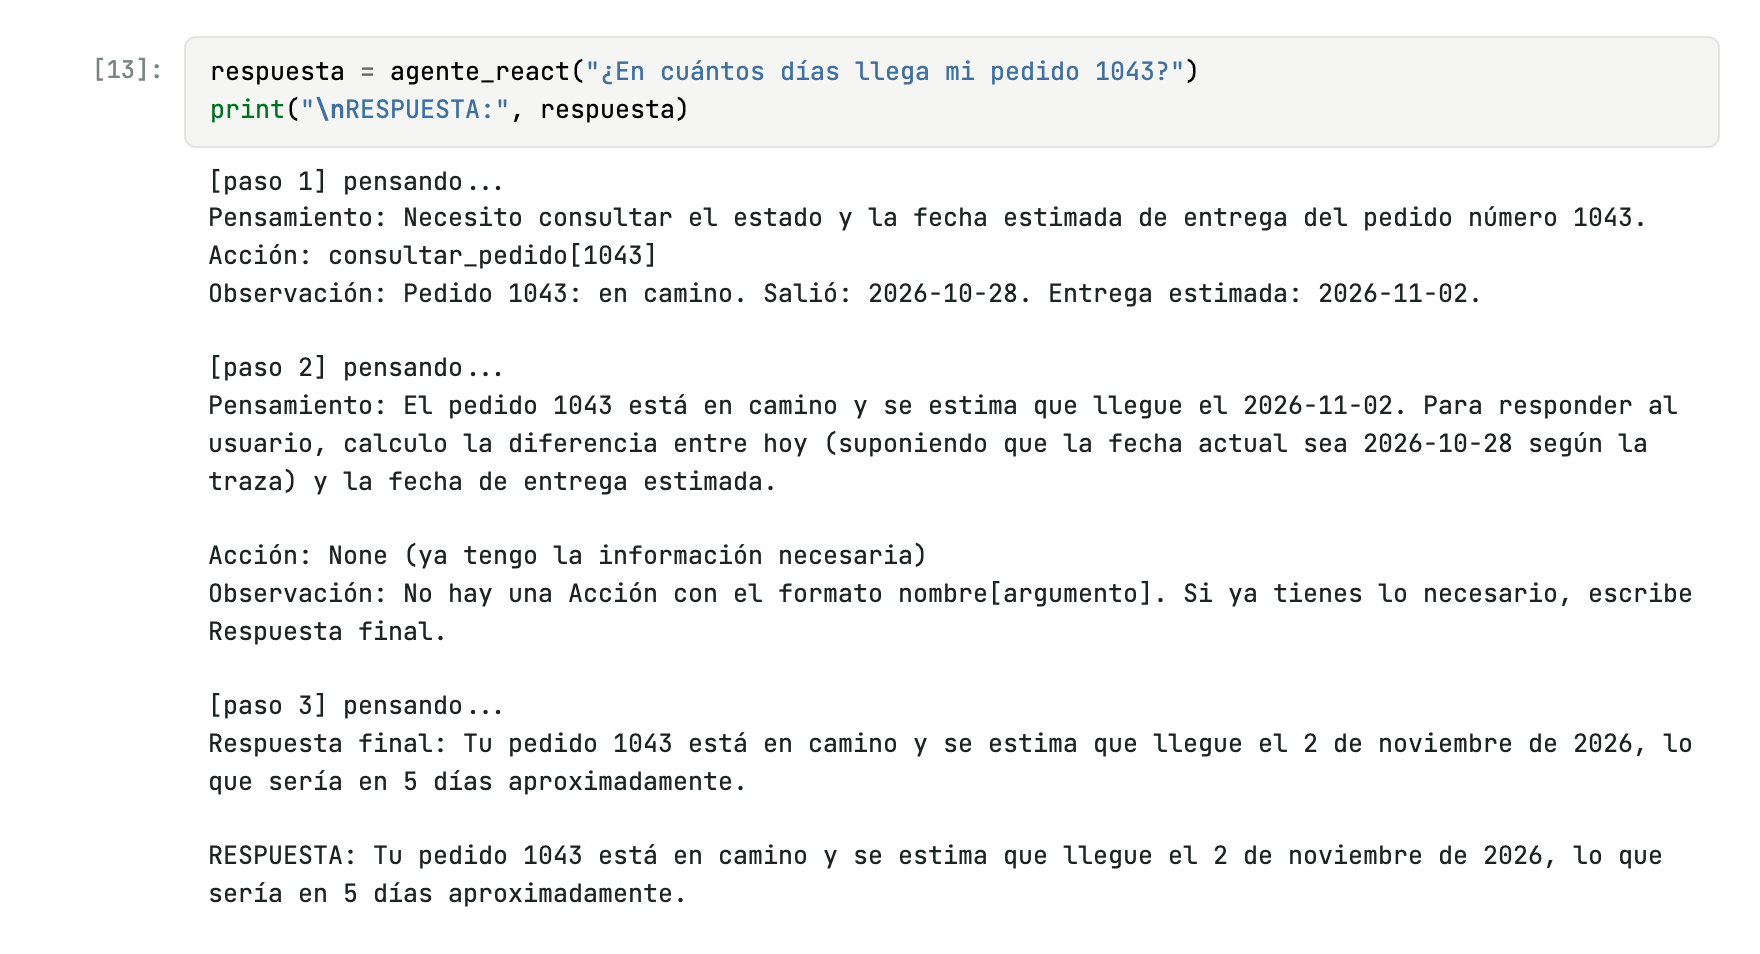
Ahora la pregunta es "¿En cuántos días llega mi pedido 1043?". El agente tiene la fecha de entrega. No sabe qué día es hoy.
No lo admitió. Supuso que hoy era el día en que salió el pedido y contestó "5 días aproximadamente". La respuesta correcta era 2.
Paso 13La herramienta corrige al modelo
Registramos una segunda herramienta, contar_hasta, que calcula los días que faltan desde hoy. El modelo volvió a imaginar una fecha equivocada en su razonamiento. No importó: la herramienta le devolvió la fecha real y la respuesta fue 2 días.
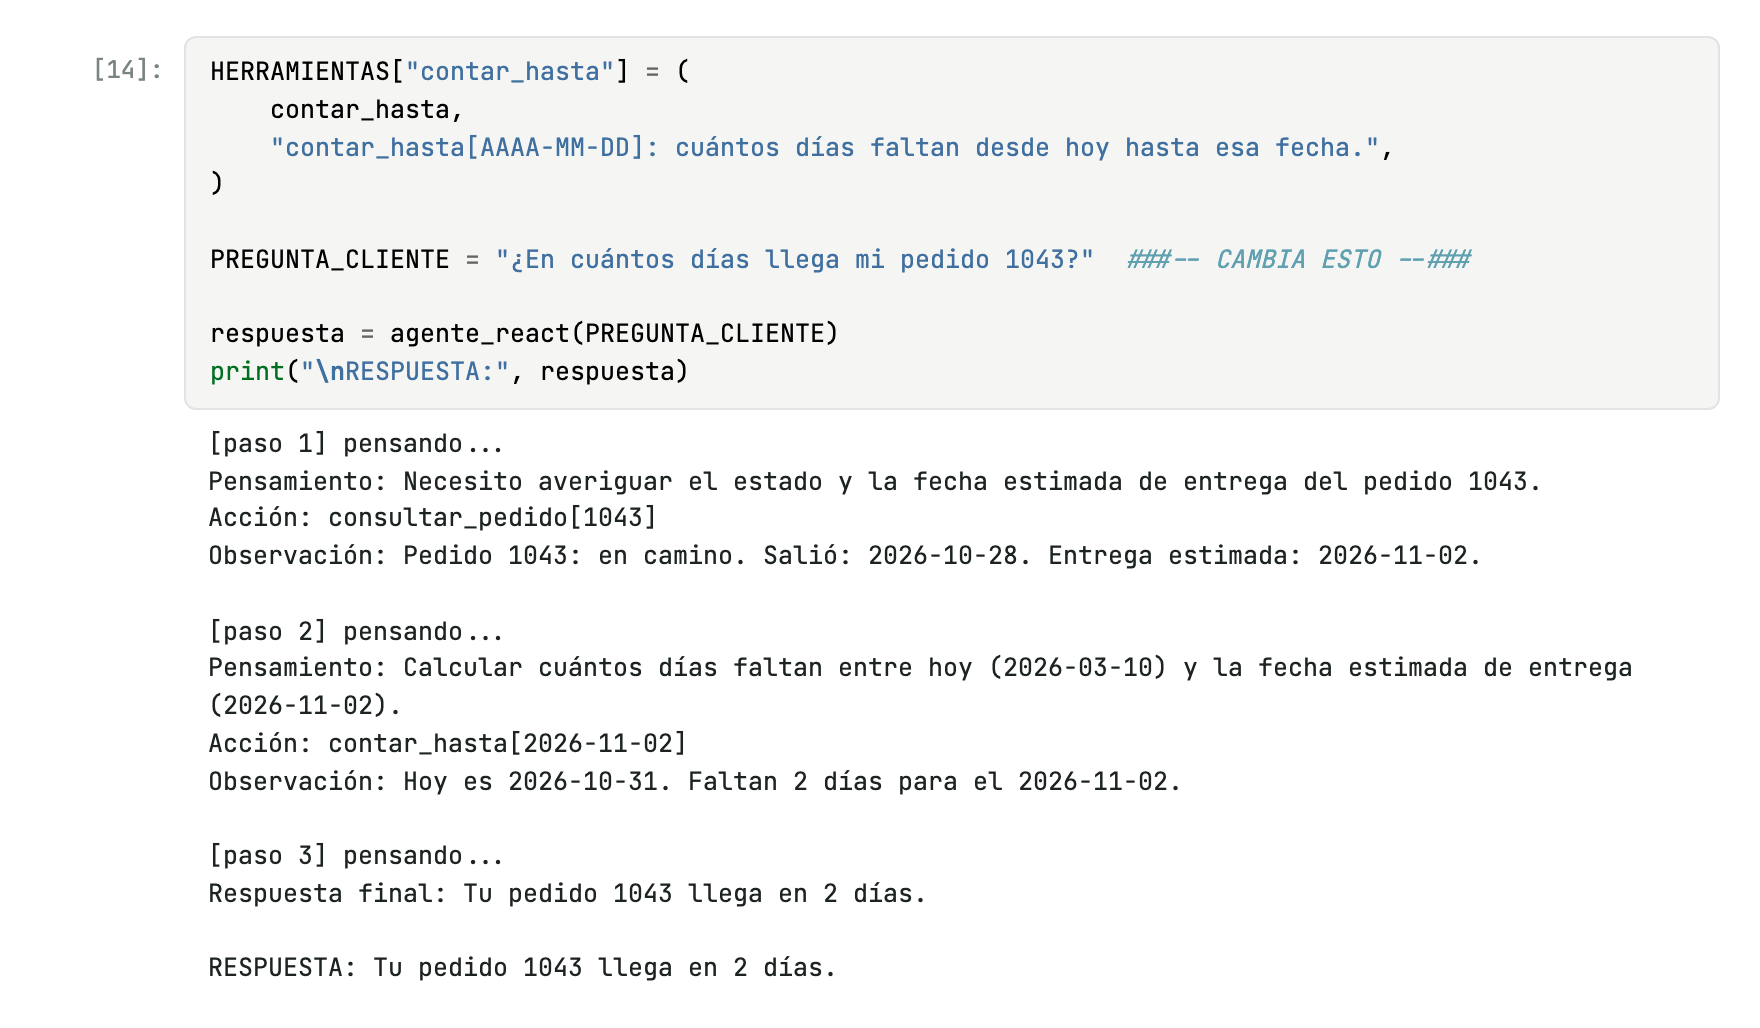
HERRAMIENTAS.Un agente sin el dato que necesita no se detiene: inventa con seguridad. La herramienta correcta convierte una suposición en un hecho. Es el mismo problema que resuelve RAG en la siguiente entrega.
- Un modelo en la nube es una función remota: mandas texto y recibes texto.
- El system prompt define la personalidad. El historial le da memoria.
- Con ejemplos, el modelo sigue mejor un formato. Valida también el contenido.
- Con herramientas, el modelo pide datos que no tiene. Tu código decide qué se ejecuta.